
Normalerweise schickt deine Anwendung bei jeder Anfrage den ganzen bisherigen Chatverlauf mit. Mit dem Brain FlowModels musst du das nicht. Du gibst nur an, für welchen Endnutzer die Anfrage ist und welche Unterhaltung du fortsetzt. Den Verlauf, die Erinnerungen und die Dokumente dieser Person ergänzen wir selbst.
Ohne und mit Brain
- Ohne
external_identifiergehört der Verlauf dir. Du schickst alle nötigen Nachrichten selbst mit, wir speichern keinen Gesprächsverlauf. - Mit
external_identifierschaltest du das Brain ein. Wir speichern die Unterhaltung, ziehen passende Erinnerungen und Dateiabschnitte dieser Person heran und passen den Kontext an das Eingabefenster des Modells an.
Beides funktioniert bei /chat/completions und /responses, jeweils auch mit Streaming.
Die erste Nachricht
{
  "model": "groq/openai/gpt-oss-120b",
  "external_identifier": "kunde-1042",
  "messages": [{"role": "user", "content": "Ich plane einen Relaunch unserer Website. Womit fange ich an?"}]
}
external_identifier ist deine eigene, stabile Kennung für die Person, 1 bis 255 Zeichen. Auch eine Kundennummer schickst du als Text, also "1042" statt 1042. Kennen wir die Kennung noch nicht, legen wir den Endnutzer beim ersten Aufruf automatisch an.
Die Antwort enthält zusätzlich das Feld conversation mit einer UUID. Speichere sie zusammen mit dem Chat in deiner Anwendung.
Die Unterhaltung fortsetzen
Bei der nächsten Nachricht schickst du dieselbe Kennung, die conversation und nur die neue Nachricht:
{
  "model": "groq/openai/gpt-oss-120b",
  "external_identifier": "kunde-1042",
  "conversation": "018f1234-5678-7abc-9def-0123456789ab",
  "messages": [{"role": "user", "content": "Gib mir dazu drei konkrete nächste Schritte."}]
}
Schickst du den alten Verlauf trotzdem mit, steht er doppelt im Kontext. Das kostet mehr Tokens und verwirrt das Modell. Lässt du conversation weg, beginnt eine neue Unterhaltung mit demselben Endnutzer. Seine Erinnerungen und Dateien stehen auch dort zur Verfügung.
Drei Kennungen auseinanderhalten
| Kennung | Woher | Wofür |
|---|---|---|
external_identifier |
aus deinem System | ordnet Anfragen einer Person zu |
id des Endnutzers |
aus POST /end-users |
Verwaltung, Dateien, Löschung |
conversation |
aus der Antwort | setzt eine bestimmte Unterhaltung fort |
Willst du einen Endnutzer vorab anlegen, etwa um ihm gleich Dokumente zuzuordnen, nutzt du POST /v1/end-users mit external_identifier und optional metadata. Gibt es den Endnutzer schon, bekommst du einfach den vorhandenen zurück.
Was bei langen Unterhaltungen passiert
Wird eine Unterhaltung länger als das Eingabefenster des Modells, fassen wir ältere Abschnitte zusammen und speichern die Zusammenfassung. Die jüngsten Nachrichten bleiben im Wortlaut erhalten. Jeder Abschnitt wird nur einmal zusammengefasst und bezahlt. Auch diese Zusammenfassungen gehören zu deinem Verbrauch. Mehr dazu in Zu langer Verlauf: context_length_exceeded und Verlaufsverdichtung.
Endnutzer in der Oberfläche
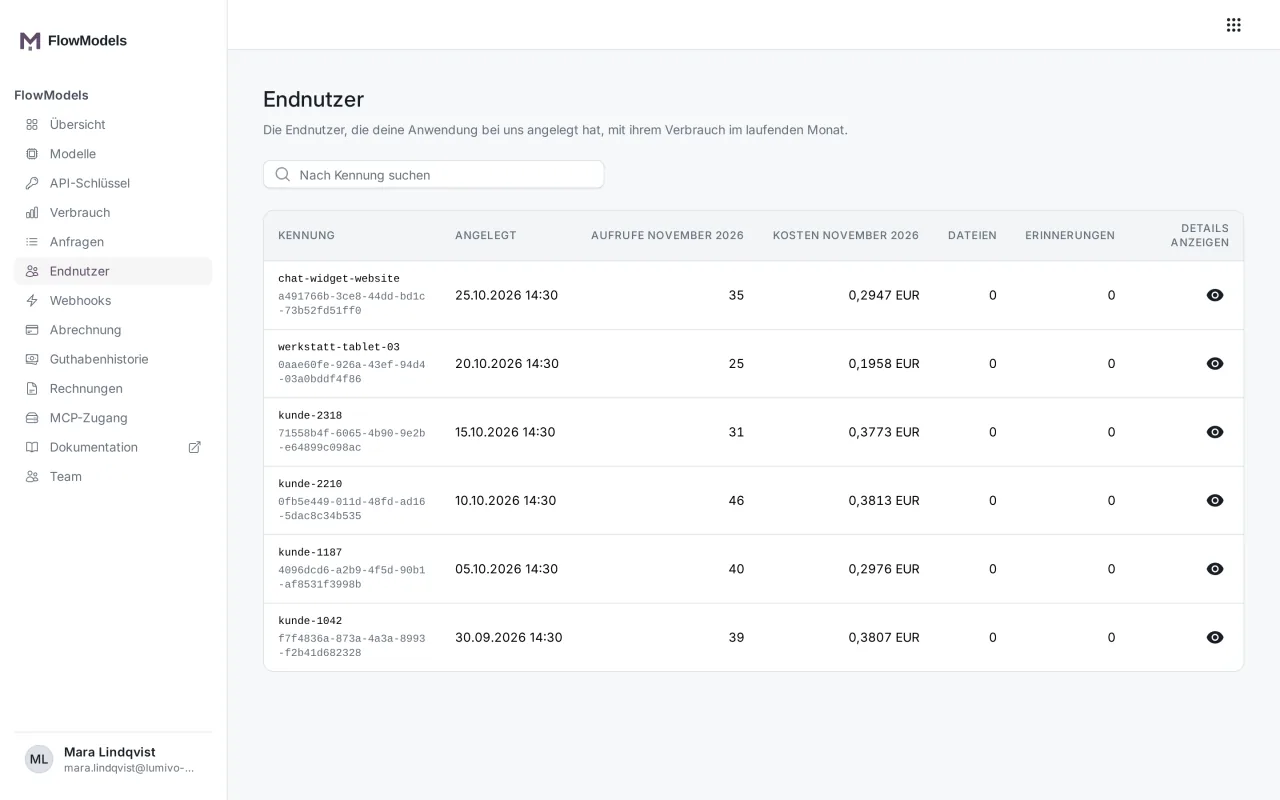
Unter Endnutzer siehst du alle Endnutzer mit ihrer Kennung, den Aufrufen und Kosten im laufenden Monat sowie der Zahl ihrer Dateien und Erinnerungen. Wie du die Liste nutzt, steht in Endnutzer deiner Anwendung verwalten.
Automatische Erinnerungen
Das Brain merkt sich wichtige Angaben aus den Unterhaltungen automatisch als Erinnerungen, etwa „bevorzugt kurze Antworten“. Bei neuen Endnutzern ist das eingeschaltet. Abschalten kannst du es je Endnutzer mit PATCH /end-users/{id} und "memory_extraction_enabled": false. Erinnerungen selbst anlegen und bearbeiten erklärt Erinnerungen eines Endnutzers per API anlegen, suchen und ändern.
Wenn etwas nicht klappt
404 conversation_not_found: Dieconversationgibt es nicht, oder sie gehört zu einem anderen Endnutzer. Prüfe, ob du die richtige Kombination ausexternal_identifierundconversationschickst.409 conversation_in_progress: Für dieselbe Unterhaltung läuft schon eine Anfrage. Warte deren Antwort ab, bevor du die nächste schickst.- Das Brain erinnert sich nicht: Prüfe, ob du
external_identifierwirklich im JSON-Inhalt schickst. In der Python-Bibliothek gehört es inextra_body. Das Felduserreicht nicht. Es dient nur der Missbrauchsnachverfolgung und schaltet kein Brain ein.
Gut zu wissen
Verwende als Kennung eine neutrale ID aus deinem System, keine E-Mail-Adresse und keinen Namen. So bleiben personenbezogene Daten bei dir.