
Embeddings verwandeln Texte in Zahlenreihen, sogenannte Vektoren. Ähnliche Texte bekommen ähnliche Vektoren. Das brauchst du für eine semantische Suche, für Empfehlungen oder um Dokumente nach Themen zu gruppieren. FlowModels bietet dafür den Endpunkt POST /v1/embeddings im Format von OpenAI.
Welche Modelle es gibt
Für Embeddings sind ausschließlich die dafür freigegebenen Modelle erlaubt, derzeit openai/text-embedding-3-small und openai/text-embedding-3-large. In der Modellliste unter Modelle findest du sie mit dem Filter Art auf Embedding, dort stehen auch die Preise.
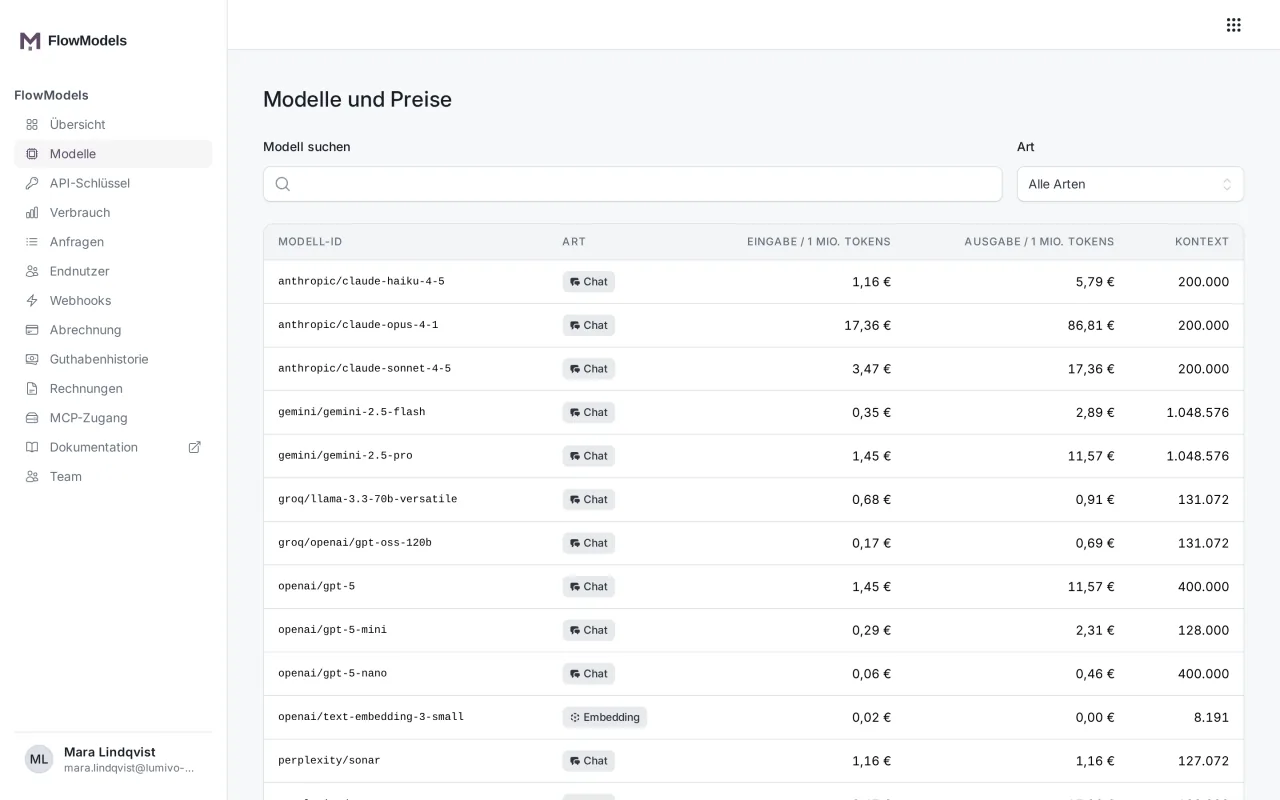
Schickst du ein Sprachmodell an diesen Endpunkt, lehnt die API die Anfrage mit 400 unsupported_for_model ab, bevor etwas reserviert oder berechnet wird.
Eine Anfrage senden
curl https://api.flowmodels.one/v1/embeddings \
  -H "Authorization: Bearer at_dein_schluessel" \
  -H "Content-Type: application/json" \
  -d '{"model": "openai/text-embedding-3-small", "input": ["Wie ändere ich meine Lieferadresse?", "Lieferadresse nachträglich anpassen"]}'
Mit der OpenAI-Bibliothek für Python:
result = client.embeddings.create(
    model="openai/text-embedding-3-small",
    input=["Wie ändere ich meine Lieferadresse?", "Lieferadresse nachträglich anpassen"],
)
vektor = result.data[0].embedding
Wie du die Bibliothek auf FlowModels einstellst, steht in Die OpenAI-Bibliothek für Python und Node.js mit FlowModels nutzen.
Die Antwort
{
  "object": "list",
  "data": [
    {"object": "embedding", "embedding": [0.0023, -0.0091, …], "index": 0},
    {"object": "embedding", "embedding": [0.0114, 0.0072, …], "index": 1}
  ],
  "model": "openai/text-embedding-3-small",
  "usage": {"prompt_tokens": 16, "total_tokens": 16, "cost": "0.000004", "currency": "EUR"}
}
Die Vektoren kommen in derselben Reihenfolge wie deine Eingaben. index nennt die Position zusätzlich. In usage.cost steht, was die Anfrage in Euro gekostet hat.
Viele Texte auf einmal
input ist entweder ein einzelner Text oder eine Liste von Texten. Eine Liste darf höchstens 2.048 Einträge haben, jeder Eintrag höchstens 8.192 Zeichen. Überschreitest du eine der Grenzen, wird die Anfrage abgelehnt, nicht gekürzt. Teile große Bestände also selbst in Pakete auf.
Ein Paket wird in einem einzigen Aufruf beim Anbieter verarbeitet und einmal berechnet. Viele Texte in einer Anfrage zu bündeln, schont außerdem dein Anfragelimit je Minute.
Weitere Felder
encoding_format:floatliefert die Vektoren als Zahlenliste, das ist der Standard.base64liefert sie als Base64-kodierte 32-Bit-Gleitkommazahlen in Little-Endian-Reihenfolge. Das ist das Format, das die OpenAI-Bibliotheken intern erwarten, und es überträgt deutlich weniger Daten.dimensions: die gewünschte Länge der Vektoren, sofern das Modell das unterstützt. Kürzere Vektoren brauchen weniger Speicher in deiner Datenbank.user: eine eigene Kennung des Endnutzers zur Missbrauchsnachverfolgung.
Gut zu wissen
- Embeddings haben kein Brain, keinen Verlauf und kein Streaming.
external_identifierspielt hier keine Rolle. - Vergleiche immer Vektoren desselben Modells. Vektoren von
text-embedding-3-smallundtext-embedding-3-largepassen nicht zueinander. - Wenn du Dokumente nur für das Brain eines Endnutzers bereitstellen willst, musst du keine eigenen Embeddings erzeugen. Das übernehmen wir, siehe Dokumente für einen Endnutzer hochladen und als Kontext nutzen.