
Embeddings transformam textos em sequências de números, os chamados vetores. Textos parecidos recebem vetores parecidos. Você precisa disso para uma busca semântica, para recomendações ou para agrupar documentos por tema. O FlowModels oferece para isso o endpoint POST /v1/embeddings, no formato da OpenAI.
Quais modelos existem
Para embeddings, só são permitidos os modelos liberados para isso, atualmente openai/text-embedding-3-small e openai/text-embedding-3-large. Na lista em Modelos, você os encontra com o filtro Tipo em Embedding, onde também estão os preços.
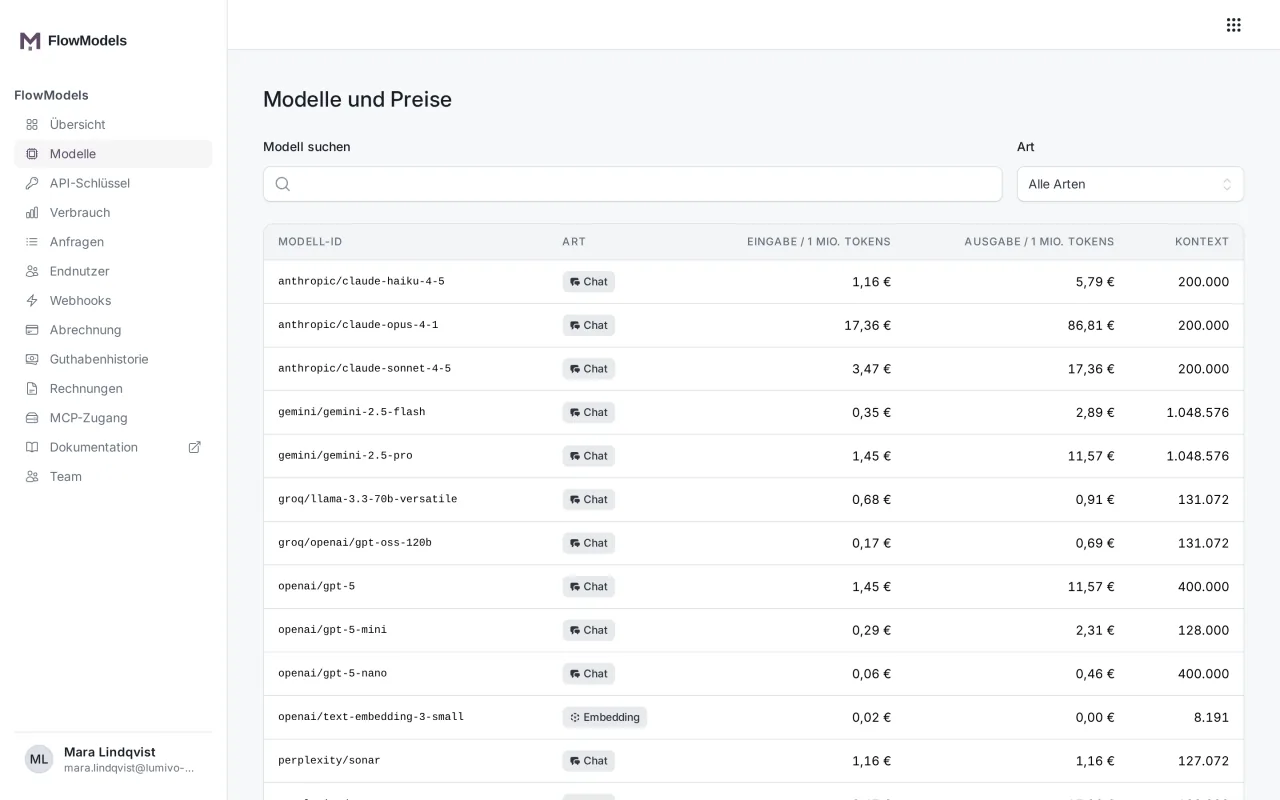
Se você enviar um modelo de linguagem para esse endpoint, a API recusa a requisição com 400 unsupported_for_model, antes de qualquer reserva ou cobrança.
Enviar uma requisição
curl https://api.flowmodels.one/v1/embeddings \
  -H "Authorization: Bearer at_sua_chave" \
  -H "Content-Type: application/json" \
  -d '{"model": "openai/text-embedding-3-small", "input": ["Como altero meu endereço de entrega?", "Ajustar o endereço de entrega depois do pedido"]}'
Com a biblioteca da OpenAI para Python:
result = client.embeddings.create(
    model="openai/text-embedding-3-small",
    input=["Como altero meu endereço de entrega?", "Ajustar o endereço de entrega depois do pedido"],
)
vetor = result.data[0].embedding
Como apontar a biblioteca para o FlowModels está em Usar a biblioteca da OpenAI para Python e Node.js com o FlowModels.
A resposta
{
  "object": "list",
  "data": [
    {"object": "embedding", "embedding": [0.0023, -0.0091, …], "index": 0},
    {"object": "embedding", "embedding": [0.0114, 0.0072, …], "index": 1}
  ],
  "model": "openai/text-embedding-3-small",
  "usage": {"prompt_tokens": 16, "total_tokens": 16, "cost": "0.000004", "currency": "EUR"}
}
Os vetores vêm na mesma ordem das suas entradas. index também informa a posição. Em usage.cost aparece quanto a requisição custou em euros.
Vários textos de uma vez
input é um único texto ou uma lista de textos. Uma lista pode ter no máximo 2.048 entradas, cada uma com no máximo 8.192 caracteres. Se você ultrapassar um desses limites, a requisição é recusada, não cortada. Portanto, divida você mesmo os volumes grandes em lotes.
Um lote é processado em uma única chamada ao provedor e cobrado uma vez. Agrupar muitos textos em uma requisição também poupa seu limite de requisições por minuto.
Outros campos
encoding_format:floatretorna os vetores como lista de números, que é o padrão.base64os retorna como números de ponto flutuante de 32 bits codificados em Base64, em ordem little-endian. É o formato que as bibliotecas da OpenAI esperam internamente, e ele transfere bem menos dados.dimensions: o comprimento desejado dos vetores, se o modelo aceitar. Vetores mais curtos ocupam menos espaço no seu banco de dados.user: um identificador próprio do usuário final, para rastrear abuso.
Bom saber
- Embeddings não têm Brain, histórico nem streaming.
external_identifiernão tem efeito aqui. - Compare sempre vetores do mesmo modelo. Vetores de
text-embedding-3-smalletext-embedding-3-largenão são compatíveis entre si. - Se você quer disponibilizar documentos apenas para o Brain de um usuário final, não precisa gerar embeddings próprios. Nós cuidamos disso, veja Enviar documentos para um usuário final e usá-los como contexto.