
Die Modelle hinter von FlowModels sind sehr unterschiedlich. Manche sehen Bilder, manche denken länger nach, manche nehmen kein temperature an. Damit du das nicht erst an einer Fehlermeldung merkst, beschreibt die Modellliste jedes Modell genau. Hier erfährst du, welche Angaben du findest und wie du sie liest.
Die Modellliste in der Oberfläche
Unter Modelle siehst du alle freigegebenen Modelle mit Art, Modell-ID, den Preisen für Eingabe / 1 Mio. Tokens und Ausgabe / 1 Mio. Tokens sowie dem Kontext, also wie viele Tokens das Modell insgesamt verarbeiten kann. Bei Video- und Bildmodellen steht statt der Tokenpreise der Preis je Sekunde beziehungsweise je Bild. Wie du die Preise liest, steht in Modelle und Preise von FlowModels.
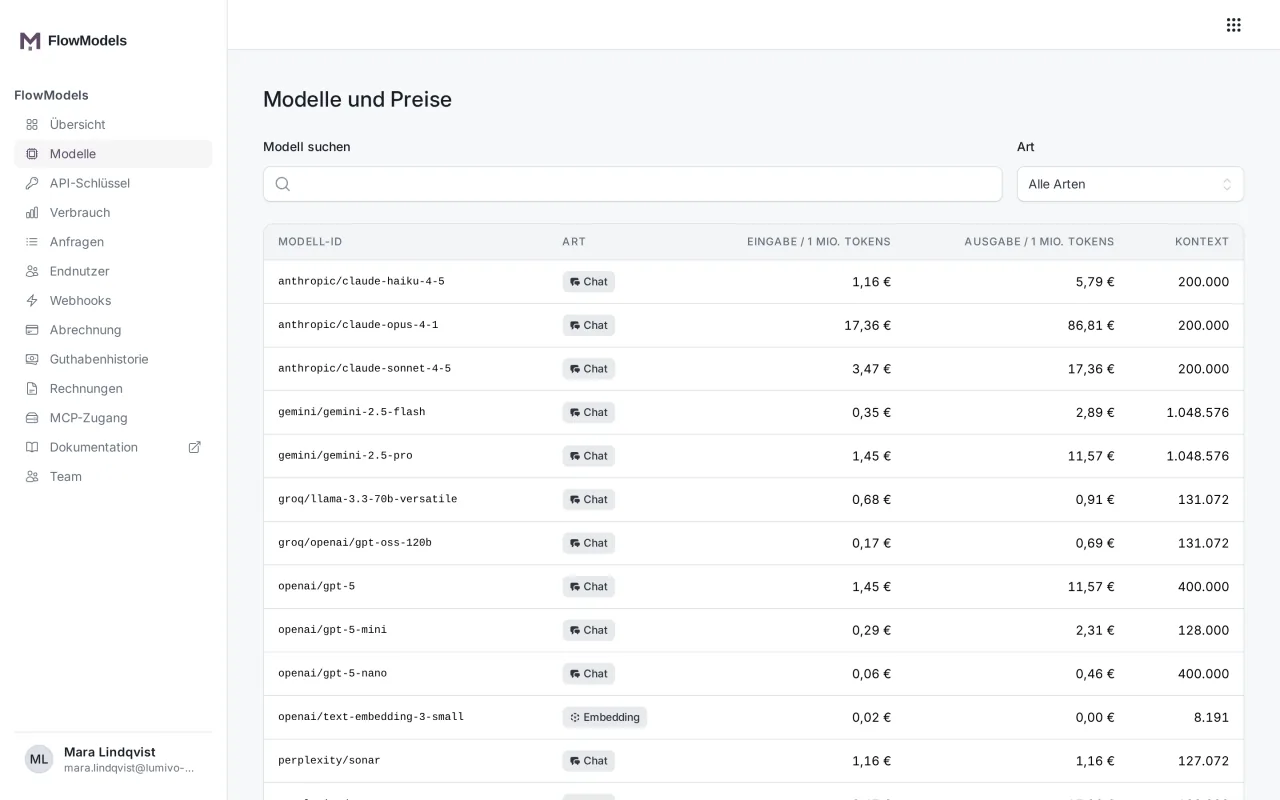
Die Fähigkeiten eines Modells zeigt die Oberfläche nicht. Die liefert dir die Schnittstelle.
Die Modellliste per API
GET /v1/models liefert alle Modelle, die dein Team nutzen kann. Die Liste ist seitenweise aufgebaut: Steht in der Antwort has_more: true, holst du die nächste Seite mit ?after= und dem Wert aus last_id. Ein einzelnes Modell bekommst du über GET /v1/models/groq/openai/gpt-oss-120b. Die Schrägstriche in der Kennung bleiben dabei einfach stehen.
Die wichtigsten Felder eines Eintrags:
kind: wofür das Modell gedacht ist, etwachat,embedding,audio,videooderimage. Für/chat/completionsund/responsessind nur Modelle mitchaterlaubt.context_length: das Kontextfenster laut Anbieterflowai_limits: die Grenzen, die bei uns tatsächlich gelten, unter andereminput_tokensundmax_output_tokenscapabilities: die Fähigkeiten des Modellssupported_parameters: die Anfragefelder, die das Modell wirklich auswertetpricing: die Preise in Euro je Million Tokens, bei Video- und Bildmodellen je Sekunde beziehungsweise je Bild
Weichen context_length und flowai_limits.input_tokens voneinander ab, gilt für deine Anfrage der Wert aus flowai_limits. Steht dort null, gibt es keine Angabe. Das bedeutet nie „unbegrenzt“.
Video- und Bildmodelle
Video- und Bildmodelle beschreiben ihre Möglichkeiten nicht über capabilities, sondern über ein eigenes Feld:
video: ob das Modell aus Text oder aus einem Startbild arbeitet, die erlaubte Dauer, Auflösungen und Seitenverhältnisse, ob es Ton erzeugt und ob es ein Endbild annimmtimage: die Formate, die Qualitäten und ob das Modell eine Vorlage bearbeiten kann
Unter pricing.variants steht für jede Kombination der Preis je Sekunde (per_second) oder je Bild (per_image). Kann ein Bildmodell bearbeiten, steht dort zusätzlich der Preis einer Bearbeitung (per_image_edit). Videos werden erst nach der Lieferung abgerechnet, Bilder erst nach dem Speichern. Diese Modelle nutzt du nur über ihre eigenen Endpunkte, nicht für Chat. Details stehen in Videos erzeugen und Bilder erzeugen und bearbeiten.
Fähigkeiten lesen
Unter capabilities stehen Merkmale mit true oder false, zum Beispiel:
| Feld | Bedeutung |
|---|---|
vision |
Das Modell sieht Bilder. |
tools, tool_choice, parallel_tool_calls |
Das Modell kann deine Funktionen aufrufen. |
json_object, json_schema |
Das Modell liefert JSON beziehungsweise JSON nach Schema. |
web_search, web_search_forced |
Das Modell kann im Web suchen oder sucht immer. |
reasoning, reasoning_levels |
Das Modell denkt vor der Antwort nach, und diese Stufen kannst du wählen. |
sampling |
Das Modell nimmt Felder wie temperature und top_p an. |
streaming |
Das Modell kann seine Antwort streamen. |
Schickst du ein Feld, das in supported_parameters fehlt, lehnt die API die Anfrage mit 400 unsupported_for_model ab, statt das Feld still zu ignorieren. Das klassische Beispiel ist temperature bei einem Modell mit festem Sampling. Die Rohangaben der Anbieter stehen zusätzlich in provider_metadata. Sie sind je Anbieter anders aufgebaut und keine Zusage.
Ausgabelänge: max_tokens
Mit max_tokens (bei /responses heißt das Feld max_output_tokens) begrenzt du die Länge der Antwort. Erlaubt sind 1 bis 128.000.
- Lässt du das Feld weg, gilt das Maximum des Modells. Ist für ein Modell keines hinterlegt, sind es 4.096 Tokens.
- Ein Wert über dem Maximum des Modells wird mit
400 invalid_field_valueabgelehnt. Die Fehlermeldung nennt das Maximum. - Modelle von OpenAI brauchen mindestens 16 Tokens.
Denktiefe: reasoning_effort
Modelle mit Reasoning denken vor der Antwort nach. Wie gründlich, steuerst du mit reasoning_effort, bei /responses mit reasoning.effort. Mögliche Stufen sind none, minimal, low, medium, high, xhigh und max. Welche davon ein Modell annimmt, steht in capabilities.reasoning_levels. Ohne Angabe gilt die Voreinstellung des Anbieters. Mehr Denktiefe heißt meist bessere Antworten bei schwierigen Aufgaben, aber auch mehr Tokens und damit höhere Kosten.
Grenzen einer einzelnen Anfrage
Für jede Anfrage gelten außerdem feste Obergrenzen: höchstens 4 MiB JSON, 1.000 Nachrichten, 1.000.000 Zeichen je Nachricht und 128 Funktionen in tools. Du findest sie auch in flowai_limits und in GET /v1/key. Wie viele Anfragen du je Minute senden darfst, erklärt Anfragelimit: So funktionieren die Stufen.
Wenn etwas nicht klappt
404 model_not_found: Die Kennung gibt es nicht, oder für das Modell ist gerade kein Preis hinterlegt. Gleiche sie mit der aktuellen Liste ab.400 unsupported_for_modelmitparammodel: Du hast ein Modell einer anderen Art verwendet, zum Beispiel ein Embedding-Modell für einen Chat.410 model_deprecated: Das Modell wurde abgekündigt. Schon vorher kündigen die HeaderDeprecationundSunsetdas an. Details stehen in Modelle und Preise von FlowModels.