
Os modelos por trás do FlowModels são muito diferentes entre si. Alguns veem imagens, outros raciocinam por mais tempo, outros não aceitam temperature. Para você não descobrir isso só em uma mensagem de erro, a lista de modelos descreve cada modelo em detalhes. Veja aqui quais informações existem e como lê-las.
A lista de modelos na interface
Em Modelos, você vê todos os modelos liberados com Tipo, ID do modelo, os preços de Entrada / 1 milhão de tokens e Saída / 1 milhão de tokens e o Contexto, ou seja, quantos tokens o modelo consegue processar no total. Nos modelos de vídeo e de imagem, aparece o preço por segundo ou por imagem no lugar dos preços por token. Como ler os preços está em Modelos e preços do FlowModels.
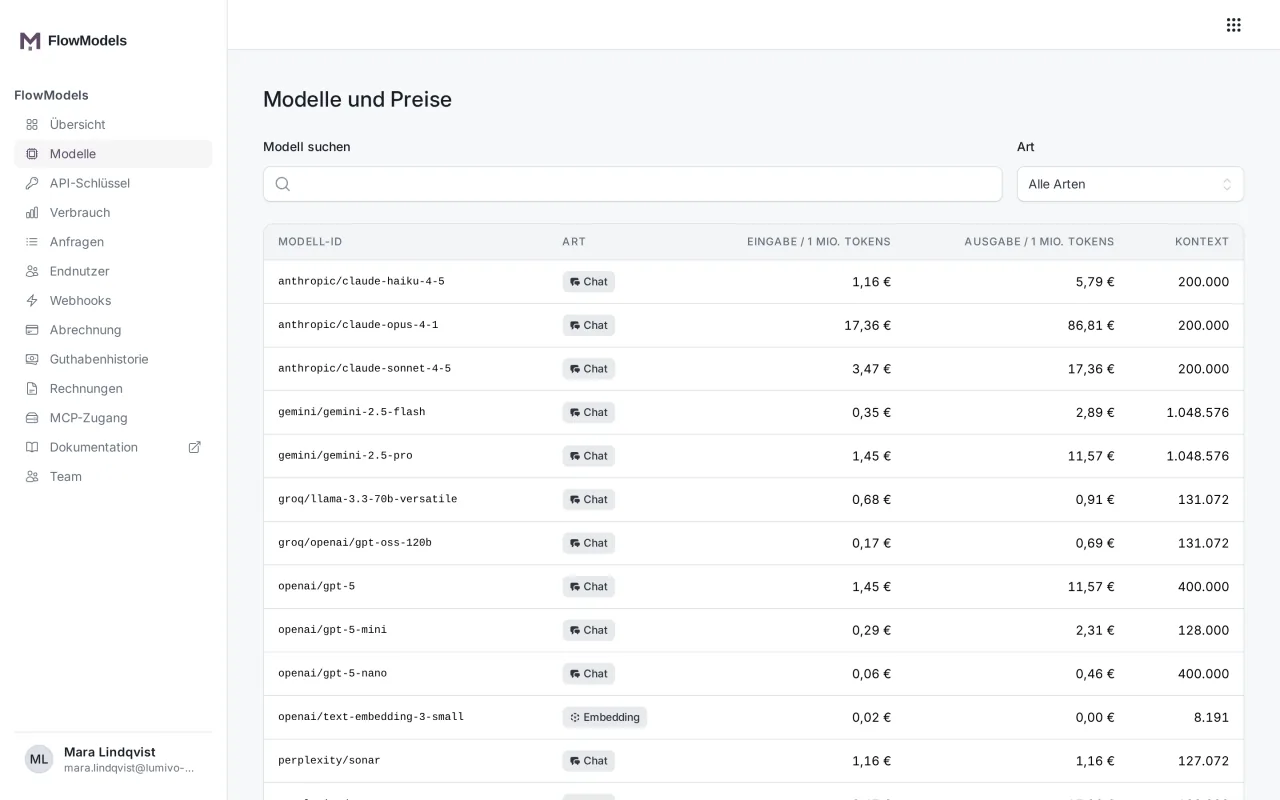
A interface não mostra as capacidades de um modelo. Elas vêm da API.
A lista de modelos pela API
GET /v1/models retorna todos os modelos que sua equipe pode usar. A lista é paginada: se a resposta trouxer has_more: true, busque a próxima página com ?after= e o valor de last_id. Para um modelo específico, use GET /v1/models/groq/openai/gpt-oss-120b, mantendo as barras do identificador.
Os campos mais importantes de uma entrada:
kind: para que o modelo serve, por exemplochat,embedding,audio,videoouimage. Em/chat/completionse/responses, só são permitidos modeloschat.context_length: a janela de contexto segundo o provedorflowai_limits: os limites que valem de fato aqui, entre elesinput_tokensemax_output_tokenscapabilities: as capacidades do modelosupported_parameters: os campos da requisição que o modelo realmente processapricing: os preços em euros por milhão de tokens, nos modelos de vídeo e de imagem por segundo ou por imagem
Se context_length e flowai_limits.input_tokens forem diferentes, vale para sua requisição o valor de flowai_limits. Se ali constar null, não há informação. Isso nunca significa “ilimitado”.
Modelos de vídeo e de imagem
Os modelos de vídeo e de imagem não descrevem o que sabem fazer em capabilities, e sim em um campo próprio:
video: se o modelo trabalha a partir de texto ou de uma imagem inicial, a duração permitida, as resoluções e proporções, se gera som e se aceita uma imagem finalimage: os formatos, as qualidades e se o modelo pode editar uma imagem
Em pricing.variants aparece, para cada combinação, o preço por segundo (per_second) ou por imagem (per_image). Se um modelo de imagem puder editar, aparece também o preço de uma edição (per_image_edit). Os vídeos só são cobrados depois da entrega, e as imagens só depois de armazenadas. Esses modelos são usados apenas pelos próprios endpoints, não para chat. Os detalhes estão em Gerar vídeos e Gerar e editar imagens.
Ler as capacidades
Em capabilities aparecem características com true ou false, por exemplo:
| Campo | Significado |
|---|---|
vision |
O modelo vê imagens. |
tools, tool_choice, parallel_tool_calls |
O modelo pode chamar suas funções. |
json_object, json_schema |
O modelo retorna JSON, ou JSON seguindo um schema. |
web_search, web_search_forced |
O modelo pode pesquisar na web ou sempre pesquisa. |
reasoning, reasoning_levels |
O modelo raciocina antes de responder, e esses são os níveis que você pode escolher. |
sampling |
O modelo aceita campos como temperature e top_p. |
streaming |
O modelo pode transmitir a resposta em streaming. |
Se você enviar um campo que não está em supported_parameters, a API recusa a requisição com 400 unsupported_for_model, em vez de ignorar o campo sem avisar. O exemplo clássico é temperature em um modelo com sampling fixo. Os dados brutos dos provedores aparecem também em provider_metadata. Eles têm estrutura diferente em cada provedor e não representam uma garantia.
Tamanho da saída: max_tokens
Com max_tokens (em /responses, o campo se chama max_output_tokens), você limita o tamanho da resposta. São permitidos valores de 1 a 128.000.
- Se você omitir o campo, vale o máximo do modelo. Se não houver máximo registrado para um modelo, são 4.096 tokens.
- Um valor acima do máximo do modelo é recusado com
400 invalid_field_value. A mensagem de erro informa o máximo. - Modelos da OpenAI precisam de no mínimo 16 tokens.
Profundidade de raciocínio: reasoning_effort
Modelos com reasoning raciocinam antes de responder. O grau de profundidade é controlado com reasoning_effort, ou com reasoning.effort em /responses. Os níveis possíveis são none, minimal, low, medium, high, xhigh e max. Quais deles um modelo aceita aparece em capabilities.reasoning_levels. Sem indicação, vale o padrão do provedor. Mais profundidade costuma significar respostas melhores em tarefas difíceis, mas também mais tokens e, portanto, custos maiores.
Limites de uma requisição individual
Toda requisição também tem limites fixos: no máximo 4 MiB de JSON, 1.000 mensagens, 1.000.000 de caracteres por mensagem e 128 funções em tools. Eles também aparecem em flowai_limits e em GET /v1/key. Quantas requisições você pode enviar por minuto está em Limite de requisições: como funcionam os níveis.
Quando algo não funciona
404 model_not_found: o identificador não existe ou o modelo está sem preço registrado no momento. Compare com a lista atual.400 unsupported_for_modelcomparammodel: você usou um modelo de outro tipo, por exemplo um modelo de embedding em um chat.410 model_deprecated: o modelo foi descontinuado. Antes disso, os cabeçalhosDeprecationeSunsetjá avisam. Os detalhes estão em Modelos e preços do FlowModels.